Réflexion - Pour parler VibeCoding, autant le pratiquer
Je vois de plus en plus de jeux “rétro” être faits avec plus ou moins d’aide de l’IA, via ce qu’on appelle le VibeCoding (la majorité n’ayant aucun intérêt). Alors comme j’avais un besoin particulier, je m’y suis essayé aussi..mais pas pour un jeu, pour comprendre tout ce qu’il y a derrière et autour, bien que j’en connaisse déjà les contours les plus néfastes.
D’abord la définition : Wikipedia décrit cela comme “programmation au ressenti”, c’est une technique de programmation utilisant l’intelligence artificielle générative pour écrire du code informatique. Le grand modèle de langage (LLM) génère alors du code source pour créer des logiciels. “L’informaticien” ne code pas, il rédige des prompts afin de demander à un LLM de générer le code correspondant. Le rôle de “l’informaticien” consiste désormais à décrire la solution ou le besoin en formulant des prompts contextuels les plus précis possibles, assimilables à de mini-spécifications fonctionnelles. “L’informaticien” ne comprend pas systématiquement ni n’intervient sur le code produit par l’intelligence artificielle, ne se focalisant que sur la cohérence du résultat final.” Bon OK, avec mes maigres compétences en langages “modernes”, je suis le cobaye idéal. J’aime plus faire des algorithme que des programmes, la transcription et les erreurs de syntaxe m’emmerdant à un niveau intersidéral. J’ai pratiqué le basic des années 80, eu des notions de C et pour le reste je vois à peu près comment sont foutus java, python, SQL sans rentrer dedans. Mais attention, qui dit Vibecoding, peut aussi vouloir dire Slop coding, ou code dégénéré…
Quel était mon besoin?
Mon besoin de base est un gestionnaire de roms de rétrogaming des plus basiques. S’il en existe des pas trop mal sous Windows, c’est plus rare sous GNU/Linux et on arrive vite à des usines à gaz mal foutus avec des dépendances (les IA n’ont rien inventé..), des procédures d’installation alambiquées sans parler des inscriptions nécessaires dans des sites à l’ergonomie néo-stalinienne. Je veux que l’application scanne les répertoires que je lui précise, récupère nom et hash, et aille me récupérer quelques données et une pochette sur Retro-achievement et IGDB qui bénéficient d’API. J’aurais bien voulu utiliser UVList.net mais c’est protégé avec tous les soucis qu’il y a eu sur le serveur, et pas d’API (interface de programmation applicative). Je veux pouvoir trier, éditer, vérifier et dire si j’y ai joué. Je veux pouvoir exporter cela dans un format ouvert et réimporter des corrections. Je veux aussi que ça soit portable simplement et transportable sur une clé avec les roms par exemple. Pas besoin de jouer à partir de ce gestionnaire, de lancer Retroarch et tout ça. Simple ? Mouais, faut voir. Et pour moi, je ne saurais pas vers quel langage ou interface m’orienter. Je laisse donc les IA décider avec mes orientations de base.
Les deux challengers en lice
Je sais qu’il existe des IA très spécialisés, voir locaux (voir aussi ce que fait et teste David Larlet par exemple) mais je suis parti sur deux leaders du domaine au niveau grand public : ChatGPT d’OpenAI en version gratuite (GPT-5.6 Luna) et Claude d’Anthropic aussi en version gratuite (Sonnet 5), volontairement ceux qui doivent être parmi les plus gourmands et fermés. Dans un premier temps, je me suis contenté de donner les fonctions de base : récupérer des données sur deux sites à partir d’une arborescence de dossiers et fichiers en différents formats (les roms sont zippées ou pas). J’avais défini 26 plateformes différentes (j’en connais plus de 200…) allant de l’Atari 2600 à l’Arduboy en passant par le MSX et l’Amiga plus les différentes bornes d’arcade. J’ai aussi créé des comptes sur les deux sites sources de données pour accéder aux API et avoir les codes associés (la plus grosse contrainte pour un utilisateur). ChatGPT, devant la possibilité d’avoir plus de 25 000 fichiers (estimation par rapport aux chiffres d’UVlist sur les plateformes émulées), a préféré partir sur une solution Web locale. Honnêtement, je n’en utilise pas autant moi même mais c’est pour essayer d’avoir des limites hautes. Claude est parti sur du Python, du Qt et on verra ensuite pour la portabilité que j’ai orienté un peu.
La structuration du projet
D’abord, j’ai travaillé un peu la structure des fichiers, leurs noms, les répertoires en reprenant aussi des standards que l’on retrouve sur les consoles retrogaming. C’est plus facile à faire du copier-coller. J’ai d’abord focalisé sur la fonction scan du répertoire puis la récupération des données (facile en ligne de commande, évidemment..). Ensuite j’ai défini les champs qui m’intéressaient de voir. J’avais prévu aussi une liste de “genre” de jeux (j’ai déjà bossé ça sur un tableur) pour limiter les doublons et avoir une cohérence entre les deux bases de référence. Tout doit-être éditable manuellement mais l’édition ne doit pas être écrasée si on redemande une requête sur un site. J’ai ensuite prévu d’avoir des recherches simples puis multicritères, puis un export de données. Il faut aussi pouvoir éditer la liste des plateformes comme on veut en définissant les emplacements des roms, notamment sur un NAS ou une clé USB (attention aux droits et au formatage…). Je vous passe certains détails d’interface qui viennent se rajouter au fur et à mesure car l’UX (expérience utilisateur) est importante pour moi.
La partie visible : le temps passé
Avec Claude, j’ai eu rapidement une version basique et fonctionnelle après 1h-1h30 de prompts maxi. Plus compliqué déjà avec ChatGPT qui n’a pas choisi une solution simple. Il m’a d’ailleurs demandé si je voulais recréer “Screenscraper”…un peu mais en mieux (j’ai utilisé aussi ça sur Android via des fronts bien connus..) et plus simple alors. Sauf que cet “imbécile” a un peu trop copié sur ce qui existe et s’en va, à mon avis dans une impasse. J’ai réussi à avoir un truc très basique au bout de 3h environ. Sauf que ça ne fait que la base et ce qui prend le temps, c’est tout le reste. Donc on pourrait croire que c’est bien plus rapide que n’importe quel programmeur, mais…
La partie moins visible : tests et finition
Sur le papier, tout paraît simple mais rien que les choix de couleur, de termes, les positionnement, les rafraîchissement, les temps de traitement sont à gérer et décrire. Même l’ordre alphabétique ou les ordres de priorité sont à définir. Le diable est dans les détails! Je veux quelque chose d’ouvert, de configurable avec des fichiers clairs qui permettent de taper dedans ou de le faire via une interface graphique. Rien que la saisie des codes des API, ça doit être au premier démarrage. Je n’ai pas voulu intégrer toutes les explications et les liens pour les chercher mais bon, ça pourrait être dans une aide. J’ai été assez agréablement surpris par la création du Readme, les commentaires dans le code python etc qui rend ça lisible, presque trop. Chat GPT a commencé à se perdre dès la version baptisée 1.5 … L’avantage de Claude a été d’avoir accès à des étapes, au détail des tests et à la logique du truc pour ceux que ça intéresse. On sent que l’outil est plus orienté sur ce type de tâches et il va souvent trop vite à passer en mode test sans attendre des réflexions sur les hypothèses. Pour ChatGPT, c’est là que la catastrophe commence. Il a ruiné son propre code dès la troisième version et semble s’être enfermé dans une boucle en ressortant la même chose en essayant soit-disant de corriger. Ce n’est pas la première fois que je vois ça avec une IA (je ne vous parle même pas des IA de conduite automobile…allez voir les cas Waymo qui en disent long sur les boucles de sécurité). Je sais déjà que je n’obtiendrai pas beaucoup mieux que dans d’autres domaines culturels où il flatte par des hallucinations. Ce qui me frappe par rapport à un humain, c’est que d’un coté on a une relation bijective avec un développeur qui interroge le client, quand l’IA n’interroge finalement que très peu et attend des informations du prompt.
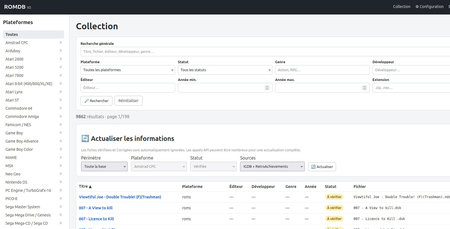
C’est ainsi que voyait Chat GPT
Je lisais en parallèle un article sur ce qu’il se passe dans le monde des jeux retro, justement. Beaucoup sont faits avec du vibe-coding mais n’aboutissent pas à un produit final justement faute de test et d’implication. (et ça semble aussi le cas sur la copie de la suite Adobe sortie récemment en IA, qui fait couler de l’encre dans le libre…) Le but est souvent de générer de belles images pour se faire mousser et ça s’arrête là. Un mal connu dans le monde des distributions Linux comme dans tant d’autres cas. Car c’est finalement ce qui prend le plus de temps. Utiliser son propre produit dans toutes les possibilités, imaginer le comportement d’autres utilisateurs, les risques. J’ai fait une version 1 qui m’était uniquement destinée. La version 2, c’était déjà une autre paire de manches.
Et la sécurité dans tout ça ?
Mon outil doit récupérer des milliers de données sur deux sites. On sent vite que ça peut partir dans le n’importe quoi malgré les protections en place sur ces sites (souvent nébuleuses…). ChatGPT en a un peu parlé…pas Claude. Il a fallu que je rajoute quelques verrous sur l’appli de Claude pour empêcher de faire certaines actions pendant que l’une fonctionne déjà en tâche de fond. Ca le faisait planter mais aucun message d’erreur ou pour dire qu’il peut y avoir problème. Pouvoir agir en manuel sur des tonnes de données, c’est aussi risqué et il faut aussi prévoir des sauvegardes, des reprises d’une version précédente ou ce genre de choses. Je connais bien le sujet sur des SGBD client/serveur alors que là je suis sur du pur local avec interrogation externe. Mon application est anodine mais j’aurais pu demander des choses plus sensibles sans faire ciller l’IA. Je ne sais pas jusqu’où il y a contrôle dans ce domaine et explication aux utilisateurs pas forcément au courant des risques. Pour un besoin plus pro, il y aurait des sujets autour de la confidentialité, de la protection du réseau interne, etc… Alors pour tout cela, j’ai rajouté un log, une possibilité de backup/restauration, et des limites en volume et temps pour l’interrogation des bases afin de respecter les autres utilisateurs. Si Claude a approuvé, il n’a jamais été force de proposition dans ce domaine, sinon pour le dimensionnement en se basant sur les données existantes. N’espérez pas, pour l’instant, beaucoup de créativité, ce sont des copieurs-pilleurs ! Le paradoxe est que les IA se positionnent maintenant comme spécialistes de détection de failles sécuritaires.
La partie encore moins visible : la maintenabilité
Comme je ne code pas une ligne dans cette affaire, je ne sais pas ce que deviendra ce programme dans un an, deux ans… Enfin si, s’il reste chez moi. J’ai un peu l’habitude à mon boulot de voir des applications internes créés par un type qui a changé de métier au bout de 3 ans et parfois quitté la boite. Et après on se retrouve à tout devoir refaire car il n’y a pas d’explications. On passe justement beaucoup de temps à rédiger les commentaires et toutes les explications. Là dessus, les IA génératives savent écrire du texte sans problème et je dois dire que c’est assez pertinent dans ce domaine. C’est juste qu’elles oublient parfois de supprimer du texte sur des fonctions qui ont disparues et on se retrouve vite avec des incohérences. Pour la structure des fichiers, c’est simple avec des noms compréhensibles et du code commenté. Donc là dessus, je me dis que je pourrais comprendre quoi faire si ça se mettait à ne plus fonctionner si au moins j’accède aux messages d’erreur…Il y en a eu dans les phases de tests et itérations. Et déjà là, il y a des erreurs de débutants avec des oublis dans les tests de non-régression, un classique. Il faut être vigilant pour retester tout ce qui fonctionnait avant, aller voir chaque détail. Mais grande inconnue sur tout ce qu’il a été nécessaire d’installer pour que python et Qt fonctionnent de concert. Je n’aurais pas su apprendre tout ça ni forcément trouvé le bon interlocuteur pour me guider en si peu de temps… Donc il y a forcément un risque aussi de ce coté.
Le cœur du problème : les dépendances
Si sur le blog, j’ai basculé sur des solutions en pur HTML, c’est parce que j’ai vu parfois des limites sur la solution Jekyll ou tout autre gestionnaire de site statique. J’ai du corriger des scripts au fil des versions. Ces moteurs dépendent d’autres bibliothèques, langages etc… Ici, j’ai eu 160 Mo à installer pour faire tourner l’application créée par Claude. J’ai demandé justement à pouvoir créer ensuite une version .Appimage qui intègre tout cela mais c’est là que le bât blesse. Au premier essai 175Mo pour une application aussi simple, c’était clairement trop et je ne suis pas compétent pour savoir ce qui coince. Déjà le fait de faire cohabiter deux API, plusieurs langages, ça m’inquiétait. Et je sais que les dépendances grossissent beaucoup ces temps-ci, souvent par fainéantise et intégration excessive. J’en avais vu plein d’inutiles sur des sites Jekyll et j’avais codé quelques bricoles moi-même pour le site. Alors là, j’imagine que c’est multiplié par 10, 100…En fait, le Vibe-Coding, c’est un peu comme une strate supplémentaire dans la programmation, un peu comme quand j’utilisais des langages visuels qui facilitaient le passage de l’algorithme au code. Maintenant nous essayons d’avoir un langage plus naturel mais il faut pourtant comprendre que derrière, il y a toujours les même mécaniques et les même écueils. Alors j’ai tenté aussi de limiter les dépendances. Déjà à force de versions, j’ai remarqué que la taille de l’Appimage avait diminué de 170 à 75Mo ce qui est déjà mieux. Mais je me suis heurté à ce que je pensais : “PySide6 embarque par défaut des modules qu’on n’utilise jamais (WebEngine, QML/Quick, Multimedia, Bluetooth, capteurs, SQL, Charts…). PyInstaller les inclut quand même par défaut.” et essayer de s’en passer introduisait des risques ou des pertes donc je me suis contenté de cet avis. Mais à force, j’ai introduit quelques pistes que l’IA a fini par suivre. Ce n’est pas forcément par un jargon technique qu’on y arrive mais en parlant de cas de tests concrets et en faisant tester des hypothèses de fonctionnement. J’ai mis 5 à 10 fois plus de temps à balayer ces hypothèses qu’à avoir un produit fonctionnel, c’est dire. Et encore ce n’était qu’une version 1.
Et enfin le résultat
Je ne vous partage que le code source sans l’Appimage, ici en téléchargement en bas de la liste. … Maintenant il faut se poser les questions sur le coût réel de tout cela. Il a fallu environ 10 versions à raison de 30 minutes en moyenne de discussions (donc des tokens derrière), itérations, ….pour ce que j’ai appelé V1, avec quelques ajouts. On parle de 10 prompts dans la limite autorisée et on trouve des chiffres variés sur la consommation énergétique, de 0,24 à 0,45 Wh et de 0,3 à 50 ml d’eau. Je préfère partir sur l’estimation haute et je prendrais donc un équivalent de 100 prompts simples dans ces 4 jours passés en petites sessions ce qui donnerait 45wh et 5 litre d’eau. Cela paraît peu si on regarde du streaming, et autre et ce que consommerait un programmeur pour cela ? Est-ce vraiment tout ? Les petits ruisseaux font les grandes rivières et je n’ai même pas réussi à aller au bout de l’expérience avec ChatGPT qui s’est enfermé dans un modèle moins créatif en essayant de recopier. La structuration des résultats de Claude me paraît en fait plus adapté à cette activité. Mais je ne suis pas apte à réaliser si le code est le plus pertinent, si le choix des langages et dépendances est le plus élégant. Je note quand même un résultat assez bluffant pour un “client lambda”. Là aussi, le risque est de se croire l’égal d’un professionnel de la profession quand on a réussi à faire ça. Mon cas était plutôt simple et pourtant j’ai déjà ressenti à un moment ce sentiment de toute puissance malsaine.
J’ai introduit l’idée d’une V2 plus perfectionnée en testant d’autres limites dans l’UX avec l’intégration du WCAG et en rajoutant pas mal de verrous. On peut vite arriver à du n’importe quoi et il faut créer des étapes de validation claires et s’obstiner à les rappeler. Mais cette V2 (dont je vous explique ensuite le devenir…) a été largement plus consommatrice car je vais chercher les points de détails comme le ferait un Beta Testeur. Je dirais là qu’on est à au moins 10 fois plus de consommation ce qui ne devient pas négligeable du tout, sans même parler de coût social. Peut-on considérer que je ne prends pas la place d’un programmeur dans cet exemple d’un besoin personnel ? Peut-être mais si d’aventure des managers préféraient agir ainsi sans trop se poser de questions ou avoir une équipe de test, ça deviendrait sérieusement problématique. Et quand on sait ce qu’il faut comme Datacenters de par le monde pour répondre à une demande exponentielle, on est totalement contre-productif, même si d’aventure on réservait cela à trouver des “solutions” aux enjeux de notre planète. Ce n’est pas du tout le cas, surtout quand on voit les pubs Google Gemini en ce moment. Quant aux solutions locales en dehors de ces “majors” de l’AI, on en parle que trop peu, encore moins sur ce qui a conduit à les créer.
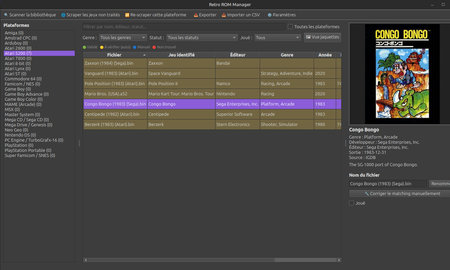
version 1 quasi finale
La profession de programmeur est-elle sinistrée ?
Au premier abord je dirais oui, et je dirais même qu’elle l’est déjà depuis longtemps à force de se laisser aller à de mauvaises pratiques : manque de commentaires dans le code, recours à trop de surcouches et de dépendances, lancement sans tests préalables faute de temps (souvent aussi sous la pression des “clients”), “rustinage”, manque de finition et ergonomies mal conçues, modes éphémères dans les langages de programmation, valse des versions dans les dépendances, API, failles sécuritaires du fait de la complexité… Le pire dans tout cela c’est que c’est cette profession même qui a nourri la bête, mais avec l’aide de beaucoup de petites mains dans des pays émergents, et du pillage de données pour gérer le langage et tous les autres domaines de ce qu’ils appellent “création”.
La profession a, par ailleurs, bien du mal à trouver des candidats humains car les environnements et besoins évoluent très vite, trop vite sans gain palpable et que maintenant on ne cherche que des esclaves de l’IA. Il faut être curieux, c’est sûr. Mais il faut aussi prendre garde dans la confiance que l’on a dans ces outils à fournir ce que l’on veut, à ne pas partir sur des pistes dangereuses ou sans issues. Et cela nécessite un minimum de connaissances, d’expérience aussi. On pourrait dire qu’il suffit de les supprimer, ces outils…Il aurait fallu dire ça il y a 3 ou 4 ans déjà, et de manière globale. Un peu comme la recherche sur le nucléaire entre les deux guerres mondiales?
J’ai été aussi demandeur d’applications avec des services internes ou externes dans mon activité professionnelle, bêta-testeur, participant à du développement et j’ai eu de bonnes et moins bonnes relations dans ce domaine. Il faut savoir présenter sa problématique, avoir un minimum structuré sa demande sinon cela ne fonctionne pas. Il faut surtout du temps et ne pas vouloir tout pour le lendemain, ce qui dans notre monde moderne est très rare. Déjà quand je reçois un nouveau matériel, mes chefs croient que cela sera opérationnel dans une semaine…et que j’aurais formé tout le monde en 2 semaines. Et bien c’est un peu pareil et l’IA nous habitue à des résultats immédiats sans se poser plus de questions. C’est évidemment très néfaste du coté client, mais même du coté fournisseur, on peut vite s’habituer à de la paresse intellectuelle et laisser faire en croyant que tout a été testé. Ici, tout semblait fonctionner tant que le seuil n’était pas atteint.
Ici, j’ai passé bien plus de temps à chercher les points de blocage, à améliorer l’ergonomie, la sécurité que pour avoir un produit qui fasse l’essentiel de ma demande. Il y a une phase de tâtonnement, de tests en charge, de tests dans divers environnement. Dans les derniers projets auxquels j’ai participé professionnellement, c’était souvent bâclé. Combien de logiciels nous arrivent en beta et c’est le client qui fait tout le boulot pour la boite qui conçoit le logiciel, alors qu’on a payé pour ça. Il est aussi clair qu’il m’aurait fallu beaucoup d’heures voir de semaines pour arriver à assimiler tout ce savoir et arriver à un dixième du résultat. Malgré cela, un pur néophyte n’y arriverait pas non plus ou tomberait dans des écueils que l’expérience m’a fait éviter…au moins en partie. Je connais encore bon nombre de failles et problèmes alors qu’en apparence, ça fait le job. Et puis pour la méthode, on va dire que j’ai fait par expérience en partant du coeur du besoin et en ajoutant petit à petit les détails. J’en ai vu qui font un peu l’inverse, en maximisant la demande à l’IA au départ (par exemple avec une demande plus vague) et en élaguant ensuite les choses inutiles. Mouais…Pas sûr que cela aurait changer grand chose, c’est un peu ce que ChatGPT a tenté de faire.
Et soudain c’est le DRAME
Justement à cause des failles, j’ai continué à vouloir optimiser le produit pour créer ce que j’appelais V2…Mais en parallèle, j’ai testé la V1 sur une très grosse base en récupérant des grosses bibliothèques de ROMs, soit 40 plateformes et 20 000 éléments. Je me suis aperçu d’autres problèmes. D’abord sur les roms de grosse taille, le hash à créer ralentit (c’est aussi le cas sur les outils de screen scrapping sur certains Front-ends Android ou Desktop. Ensuite, j’ai voulu faire une recherche d’un mot sur toute la base et ça a planté le PC car le problème de fond est le chargement des données en cache sur des plateformes avec plus de 300 ou 400 éléments, ce qui plante quand démultiplié par 40. Bref, il fallait tout reprendre. Et là, heureusement que j’avais gardé toutes les versions car évidemment, ClaudeAI n’a rien en mémoire…enfin à ce qu’il dit (oui, j’ai envie que ça soit un mec, parce qu’il y a majorité de mecs chez les codeurs et qu’en plus c’est tout pourri et que ça fait le fier ha ha). Mais on commence à voir très nettement la légèreté des tests derrière tout ça. On ne peut absolument pas demander un test en charge sur une base de pré-production par exemple, c’est bâclé. Notez que j’ai déjà eu le même résultat avec des humains, d’ailleurs parce que ça demande du temps, beaucoup de temps, et des testeurs qui ne font que ça avec une certaine discipline.
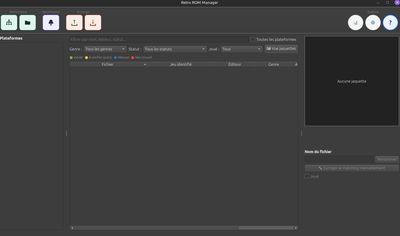
ce qu’aurait pu être la version 2 (j’ai mis 2 jours à faire comprendre que je voulais des boutons plus visibles…pas encore ceux-là, tout comme la taille de l’écriture)
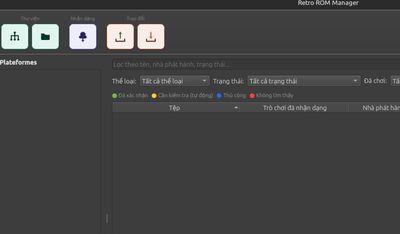
…et avec le multilingue qui était incomplet
Ce que je retiens aussi, ce sont les lacunes sécuritaires (encore que ce qui précède en fait partie) et les gros risques de mettre de tels outils dans de mauvaises mains. J’ai vu d’ailleurs passé un article sur des chercheurs ayant utilisé Claude d’Anthropic pour aller pirater un concurrent félin…Hum, pas sûr que l’IA comprenne l’humour humain et les jeux de mots. Autre élément, la vision capitaliste du produit fait que plus on l’utilise, plus il pousse à passer à la version payante… sans meilleure garantie d’accès à certains outils d’analyse, semble-t-il. Encore un piège de dépendance de plus. J’ai même vu des pertes de données, c’est dire le niveau de sécurité de ces trucs! Et plus on fait de tests complexes, plus c’est long et cher…ce qui revient à mettre en défaut le gain supposé au départ. Même un petit projet comme le mien nécessite de l’investissement et de l’énergie (dans tous les sens du terme).
Conclusion
Ma position sur l’IA ne change pas vraiment : Il faut parvenir à l’éviter dans bien des domaines, surtout les plus futiles et à verrouiller beaucoup plus les aspects sécuritaires. On ne peut nier le progrès et la rapidité pour défricher des sujets…du moins si on en a une certaine maîtrise sinon on peut se faire embobiner. Le but de ces nouveaux géants, c’est une sorte de lobotomie généralisée qui nous ferait oublier des compétences pour tout leur déléguer. Un réel danger aussi dans de mauvaises mains politiques. L’interdire ? Oui, on peut rêver. Au moins pourrait-on interdire l’installation des datacenters associés, mais…la main mise des BigTech ailleurs et leur lobbying va être dur à contourner sans être ferme. Les Finlandais l’expérimentent en ce moment … Le mirage des emplois induits ne pèsera pas lourd quand on met en face les emplois détruits et le vivant autour mais qui a le courage de cela? Nos dirigeants considèrent que ça serait prendre un retard dans bien des pans de la recherche…Certes, il y a eu des avancées majeures en science mais comprend-on tout les tenants et aboutissants ? Plus vraiment…Malheureusement, derrière tout cela, il y a l’humain, ce tricheur invétéré qui a réussi à pourrir à peu près tout ce qu’il a touché, même s’il y a eu du progrès. L’IA va faire partie de nos vies, hélas, parce que la plupart de ses applications a un ratio entre consommation et gain plutôt important, notamment sur l’eau et l’énergie. Pour mon cas, c’était une application qu’on peut qualifier de futile mais que je laisse à la communauté malgré tout et l’impact n’a pas été négligeable en poussant un peu le bouchon. Pour d’autres l’IA remplace une personne pour discuter de tout de rien ou un moteur de recherche, ou ça devient une arme à détection de failles. Je vois Chine et Inde être très présents dans ce domaine car c’est aussi un outil de manipulation de masse. Mais l’IA va aussi durablement impacter les professions et les tâches diverses. C’est justement le moment de se poser les bonnes questions mais avec les personnes qui connaissent le sujet. Je ne parlais ici que d’un de ses aspects, le codage.
Ce petit travail était l’occasion d’étendre aussi mes connaissances sur les possibilités actuelles et leurs risques. Dans mon propre métier, on vend déjà du rêve aux patrons sur les analyses de plans et de données de mesure, la programmation d’outils en automatique. Il n’y a pas encore beaucoup d’énergie mise sur ce domaine…Nous aurons quand même une stagiaire l’année prochaine sur un sujet IA. Car forcément, c’est dans le code que ça progresse le plus, et le code des IA est aussi auto-généré parfois par ces mêmes IA en mode recherche et développement. Espérons là aussi que des personnes restent compétentes pour contrôler les risques (hum…je ne parie pas). J’ai pourtant pu constater que l’on peut faire fausse route dans du développement par IA et qu’il faut des connaissances pour se prémunir de certains dangers. L’aspect monodirectionnel des dialogues est un vrai sujet qui empêche de fixer des cadres sur ce sujet du développement. Alors comment d’un coté enseigner la programmation quand une IA va plus vite à coder et tester et de l’autre coté savoir “commander” cet outil qui ne disparaîtra pas, sinon dans sa forme actuelle, distante et énergivore ? Je n’ai moi même que peu confiance dans la capacité de l’humain à s’autoréguler, comme l’histoire nous l’a montré pour le nucléaire, les armes chimiques,… Ma comparaison est volontaire quand chimie et nucléaires ont aussi donné du positif comme l’énergie ou les matériaux. Il n’y a qu’à voir comment il met toujours son intelligence au service de la destruction avec les drones en ce moment. On pourrait se contenter de dire que l’IA est interdite, comme pour la drogue (ça en est une forme)…Est-ce que ça l’a supprimé? Le champs d’investigation est donc immense et j’ai pu constaté de fait que les Lois de la robotique d’Asimov sont déjà largement mortes et enterrées avec l’IA actuelle. Effrayant ?